Cómo evolucionó nuestra forma de trabajar
Para la sorpresa de nadie, en Primo usamos AI para programar. Pero la forma en la cual lo hacemos cambió radicalmente desde que me sumé:
- Febrero 2025 - Cursor tab, escribís el código a mano y un agent te autocompleta algunas partes.
- Mayo 2025 - Cursor agents, la mayor parte del código la escribe un agent pero cada cambio se aprueba a mano.
- Julio 2025 - Cambiamos a Claude Code. Lo usamos sync en un solo worktree de git, planeando, implementando con mayor autonomía y revisando todo al final.
- Diciembre 2025 - Cambiamos a Conductor. Ahora tenemos worktrees con agents trabajando en paralelo + en auto mode, tanto con Codex como Claude Code. Ya podemos confiar más en el output.
- Mayo 2026 - Nació Primito, nuestro background agent. Ahora podés programar desde el bondi.
- Julio 2026 - Cambiamos a Orca. En lugar de orquestrar el trabajo de agents vos, lo hace un agent más inteligente (loops). Los worktrees se crean dinámicamente.
- Agosto 2026 - Amp: ahora los worktrees también corren en cloud, así trabajan 24x7 sin tener que hacer malabares para tener la Mac despierta con
caffeinate
Para evolucionar de un paso al siguiente, necesitamos que los agents ejecuten de forma autónoma por períodos más prolongados. Para eso necesitamos que los modelos sean más inteligentes, pero también tenemos que mejorar continuamente nuestro tooling. Así como humanos nos metemos en el loop cada vez más tarde.
Qué hicimos
Partimos la ejecución de una tarea en 3 etapas. A medida que mejora el tooling, el humano se puede meter más adelante y encontrarse con un output de mayor calidad.
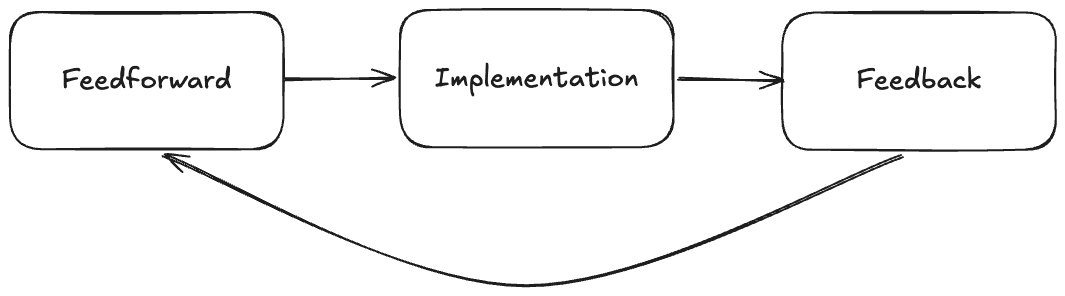
Feedforward (cómo hacer que los agents hagan las cosas bien a la primera)
- Mejoramos nuestro contexto. Lo organizamos inspirándonos en Basis + hicimos un skill de
agent-learningspara bajar el costo de entrada. Escribimos ~50 docs de contexto para agents, ~55 skills y ~100 páginas de documentación de producto en Notion. - Hicimos que Primito (nuestro background agent) nos ayude a mantenerlo con dos crons: uno para detectar drifts en la documentación (esta vez sin slop y con ownership) y otro para mejorarlo continuamente a partir de comentarios en las review de PRs.
- Le dimos más herramientas a los agents. Para poder investigar tienen que tener acceso read only y seguro a nuestra plataforma (DB, logs, observabilidad).
Implementation
- Las skills y nuestro tooling esperaban que haya un humano en el loop. Los reescribimos para que sean menos estructurados y darle más autonomía a los agents: poniendo límites al modelo hacíamos que ande peor a medida que incrementaba su inteligencia.
Feedback (cómo ayudar a que los agents corrijan su trabajo)
- Verificación manual: Le dimos herramientas al agent para interactuar con el producto como un humano y presentar evidencia que respalda que funciona bien.
- Hicimos un reviewer agentic adversarial para seguir nuestras prácticas de código, arquitectura, testing, etc.
- ⭐ Verificación automática y determinística (linters, tests): Mejoramos la forma en la cual los agents escriben tests para tener confianza en que si pasan todos los tests, no rompimos nada.
Cada punto bien podría ser un post aparte. Pero para arrancar, en este vamos a hacer deep dive en cómo resolvimos la parte de testing.
Qué no funcionó
No sirvió todo lo que hicimos:
- Julio 2025 - Probamos Background agents como Cursor, Codex y Jules → los modelos y nuestro tooling de ese momento no estaban a la altura de poder correr cosas significativas en background.
- Septiembre 2025 - Probamos Devin → nos resultó muy caro, elegimos otras soluciones que permiten usar las suscripciones de ChatGPT / Claude.
- Marzo 2026 - Armamos un Notion agent que detectaba drifts entre la documentación y los PRs → no funcionó por skill issue nuestro: el output nos quedó con mucho slop, nadie lo leía y no había ownership para corregir los drifts.
Testing
Como estamos en 2026, espero que no haga falta explicar por qué es importante tener tests en una codebase madura. Pero no todos los tests son igual de valiosos. Y los agents by default escriben muchísimos tests que no son particularmente buenos, por falta de contexto y no saber what good looks like para cada empresa.
El principio más importante por el que nos regimos se basa en este tweet:


Write tests. Not too many. Mostly integration.
Quote de Rauch de hace 10 años que sigue aplicando hoy en día. También explorado en https://kentcdodds.com/blog/write-tests
El problema son los mocks: mientras más mockeas, menos confianza tenés sobre la interacción entre los componentes que estás testeando. Y mientras más bajo el nivel del test, mayor el acople a la implementación, por lo que al refactorizar te obliga a reescribir los tests. Nuestro principio entonces es:
Los tests deberían estar ejercitados desde el nivel más alto y con la mínima cantidad de mocks que sea posible
- Not too many: mientras más alto el nivel de un test, más comportamientos se cubren con él → necesitás menos tests
- Mostly integration: hacer tests con las dependencias de verdad y no mocks
Qué construimos
Dos partes:
- Guidelines (qué): cómo se ven buenos tests en Primo
- Skill (cómo): explica a los agents cómo escribirlos
Lo publicamos en github.com/primo-devs/public-skills, donde pueden ver los detalles y usarlo.
Qué constituye un buen test (Guidelines)
- Nunca mockear el storage: o usás una DB de verdad, o reescribís la función para que sea pura (sin side effects)
- Los tests deberían ser cortos. Apuntar a 30-45 líneas.
- Change detector tests considered harmful (referencia de Testing on the Toilet de Google)
- Los tests deberían ser DAMP y no DRY (referencia de Testing on the Toilet de Google)
- Usar table driven tests solo cuando el cuerpo del test es exactamente igual y solo varía el input y el output. Si no, tests separados.
Cómo decidir qué testear (Skill testing)
- Elegir el tipo de test
Para cada aspecto de nuestra codebase, identificamos con qué estrategia debería ser testeada (el core de Primo es un monolito en Go que habla con un Postgres, servido vía HTTP)
- Lógica pura, sin side effects ni dependencias → tests unitarios
- Lógica autocontenida que usa el storage → test localizado con dependencias posta
- Todo lo demás → integration por default
- Particionar el universo de inputs en clases de equivalencia ante las cuales el sistema se comporta de la misma manera. Un test por clase. (ejemplo: lista de 2 elementos = lista de 3 elementos = “lista de más de un elemento”).
- Filtrar: Buscar razones para no escribir cada test
- Para los que sobreviven, nombrar la edición del código que los haría fallar
- Escribir el test y romper el código a mano para ver que falla (versión manual de mutation testing)
Resultado
Dado el mismo test sobre una función que procesa un archivo con pólizas y lo escribe en la DB, cómo lo escribiría el agent antes y después de la skill.
func (s *TestSuite) TestWhenProcessingFileShouldDropNonARSRows() {
		// Storage mockeado y change detector: si cambiamos la implementación
		// sin cambiar el comportamiento observable, se rompe el test
		s.storage.EXPECT().
		        InsertPolicy(gomock.Any(), s.matchPolicy("1", money.ARS)).
		        Return(nil)
		s.storage.EXPECT().
		        InsertPolicy(gomock.Any(), s.matchPolicy("2", money.USD)).
		        Times(0)

		// DRY: ¿cómo se arma y sube el archivo? ¿qué es "1" y "2"?
		s.processFileWith(map[string]string{"1": "ARS", "2": "USD"})
}func (s *TestSuite) TestWhenProcessingFileShouldDropNonARSRows() {
arsPolicyRow := newRow(withPolicyNumber("1"), withCurrency(money.ARS))
usdPolicyRow := newRow(withPolicyNumber("2"), withCurrency(money.USD))
file := s.newFile(arsPolicyRow, usdPolicyRow)
err := s.PolicyProvider.ProcessFile(file)
s.Require().NoError(err)
_, err = s.PolicyProvider.GetPolicyByNumber(arsPolicyRow.PolicyNumber)
s.NoError(err, "ARS policy should be processed")
_, err = s.PolicyProvider.GetPolicyByNumber(usdPolicyRow.PolicyNumber)
s.ErrorIs(err, ErrNotFound, "USD policy should not be processed")
}¿Cómo lo iteramos?
Lo escribimos usando la skill writing for agents de Matt Pocock, y para probarlo, vimos cómo escribía tests: para cada tipo de test suite, elegimos una existente de la codebase, la borramos y la re-generamos. Revisamos el output a ojo y con agents, iteramos la skill y repetimos el proceso de 0 hasta que estábamos contentos con el output en cada una. Mejoras concretas:
- Lógica autocontenida: testeamos nuestro pkg de parsing de números de teléfono. En la primera pasada le faltaron muchos casos en el input. Iteramos cómo expresamos la partición del input en casos de equivalencia → ✅
- Test autocontenido de un módulo: Escribió mocks a mano en lugar de usar
gomock(“no quería tocar files de producción solo para testing” 🤨). Agregamos una sección sobre mocking en Go al contexto → ✅ - Test de integración de un feature: la primera iteración mockeó todas las dependencias. No había quedado claro qué tipo de test elegir para cada caso de uso (acá claramente era integración con dependencias reales). Sección de selección de tipo de test reescrita → ✅
- Test de integración de un cliente: ya tenemos muchos ejemplos en la codebase y estos tests son históricamente los que más atención tuvieron, por lo que la skill, al tenerlos como “golden standard”, alcanzó para que funcione bien de una ✅
Resultados
Impacto que vimos, comparando PRs antes y después de la skill (~2 meses de uso)
- +25% tests de integración
- -70% tests con mocks
- 0 tests con el storage mockeado
- -54% de comentarios del estilo “este test está mal”
Además, compuso fuertemente con nuestra skill de review, que al tener las buenas prácticas de testing en el contexto, puede marcar correcciones.
Como conclusión, si bien los tests que escriben los agents son mucho mejores, todavía queda camino por recorrer. Como the code is the prompt y siguen existiendo tests históricos en la codebase, los agents aún se desvían de las guidelines para ser consistentes y escriben muchos tests en el nivel erróneo, pero con contenido correcto. Para que el slop tienda realmente a cero, queremos refactorizar la mayor parte de los tests para que sean consistentes con el nuevo estándar.
Para dónde vamos
Aún queda mucho por exprimir de los modelos. Dividimos las oportunidades de mejora en dos categorías:
- Cosas que los agents pueden resolver autónomamente
En orden de dificultad,
- Hacer triage, investigación y fix de un issue de producción a partir de una alerta
- Resolver un feature bien definido y mandar un PR que se pueda revisar y mergear
- Ambient agents que de forma autónoma encuentran cosas, las investigan y las corrigen. Como los scouts que hacen a PostHog ser self-driving.
→ tenemos que mejorar nuestra software factory (ejemplo de Vercel)
- Cosas que los agents aún no pueden resolver por su cuenta
Como dice Dex Horthy (HumanLayer) en Harness Engineering is not Enough: Why Software Factories Fail, no podemos esperar que una tarea compleja la one-shotee un agent sin que estemos en el loop. Requiere más trabajo de planificación upfront y poder expresarle mejor al agent nociones de arquitectura, calidad de código, etc.
→ para lograrlo, tenemos que mejorar nuestro harness de planificación y loop engineering.
A medida que mejoren los modelos y nuestro tooling, las cosas pasan de la segunda a la primera.
Si te interesa trabajar con devs AI-native que experimentan, aprenden e iteran: ¡estamos contratando!